raweb
成员
*** ********,负责项目所有内容开发。
项目地址
raweb
项目背景与目标
本项目旨在 rust 上解决大名鼎鼎的 C10K 问题。笔者有 C++ 方向的高性能编码经验(可见我另外一个开源项目 hpserver ),恰好 rust 也是一门着重程序性能的语言,所以尝试用rust写一个server以探究其与C/C++的区别。
rust 的 web 开发生态已然十分成熟,像 axum 或 rocket 这样的框架都已拥有生产级别的能力,本项目并不试图取代它们的生态位,而在尝试探索rust编写的server的性能上限。
系统设计与实现思路
项目采用 Master-Worker 架构,灵感来源于著名(几乎是世界上最好的)高性能HTTP服务器nginx。下图为nginx的架构。
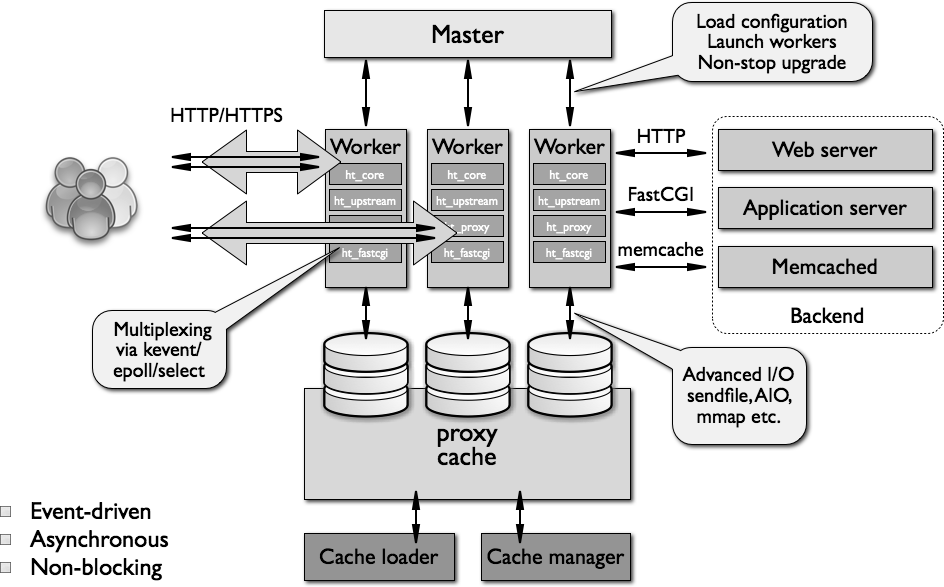
但项目并非照搬 nginx 架构,而是做了升级。rust 有十分成熟的 Tokio 异步框架,所以项目采用了 “多进程 + 异步I/O(Tokio)”的混合并发架构,在每个 worker 进程中。这种设计结合了 nginx 的多进程隔离优势与现代异步框架的高并发 I/O 处理能力。
一般来说除开这样的类 nginx 架构还有 单进程->多 Worker 线程 架构,具体实现可以参考 hpserver 项目中的 hpserver.cpp 文件。
Master
fn main() -> Result<(), Box<dyn std::error::Error>> {}Master 负责使用 fork() 创建 Worker 进程,还负责使用 sigprocmask 阻塞 SIGINT 等信号并回收子进程,保证 Master 进程中断时 Worker 进程可以正确退出不会变为僵死进程。
Worker
fn worker_loop(worker_id: usize) -> Result<(), Box<dyn std::error::Error>> {}Worker 首先会执行亲和性绑定 core_affinity::set_for_current(core_id),避免跨核缓存失效造成的伪共享,然后创建 socket 进行监听。
值得一提的是,每个 Worker 线程监听的是同一个地址和同一个端口(这需要我们设置 SO_REUSEPORT 和 SO_REUSEADDR),这使得我们可以在内核级别实现负载均衡,彻底消除了用户态 accept() 锁竞争,也保证其中一个 Worker 故障不会影响到其它 Worker。这是十分经典的 nginx 做法。
Worker还设置 SO_INCOMING_CPU 将 Worker 绑死在特定 CPU 核心,这种 “Shared-nothing”设计在 seastar 等高性能网络编程框架中运用十分广泛。
Worker 与客户端建立连接后就会通过 Tokio 创建异步任务,非阻塞特性保证了其高并发能力。在 nginx 中,Worker 内部是 epoll 实现的纯 C 语言手工状态机/回调,而在 raweb 中,我们可以使用 Tokio (虽然底层也是 epoll ),使得代码可读性和可维护性更强,实现更加优雅。
需要注意的是异步任务的创建不可以产生一个新线程,不然我们的亲和性绑定就失效了。
连接处理
async fn handle_connection(mut stream: tokio::net::TcpStream) {}如前文所述,顶层架构的设计帮我们解决了大部分性能问题,所以连接处理函数只需简单写成异步函数即可。HTTP 解析的所有逻辑也放在该函数里。
我们用 stream.read().await 异步等待数据,当 stream.read() 发现底层 socket 暂时没有数据可读(WouldBlock,即 C 中的 EWOULDBLOCK)时,它返回 Poll::Pending 此时当前 task 主动把 CPU 让出给 tokio 运行时。你如果问为什么不一次性读完,可以了解一下 TCP 协议所谓“粘包问题”。
内存分配
#[global_allocator]
static GLOBAL: Jemalloc = Jemalloc;
一般 Linux 系统下的默认内存分配器是 ptmalloc ,但是它的并发性能实在惨不忍睹,换用 jemalloc 后实测 QPS 可以提升10w以上。jemalloc 相比系统默认分配器具有更优的内存碎片控制和多线程/多进程下的扩展性。
实验结果
目前项目已实现功能:
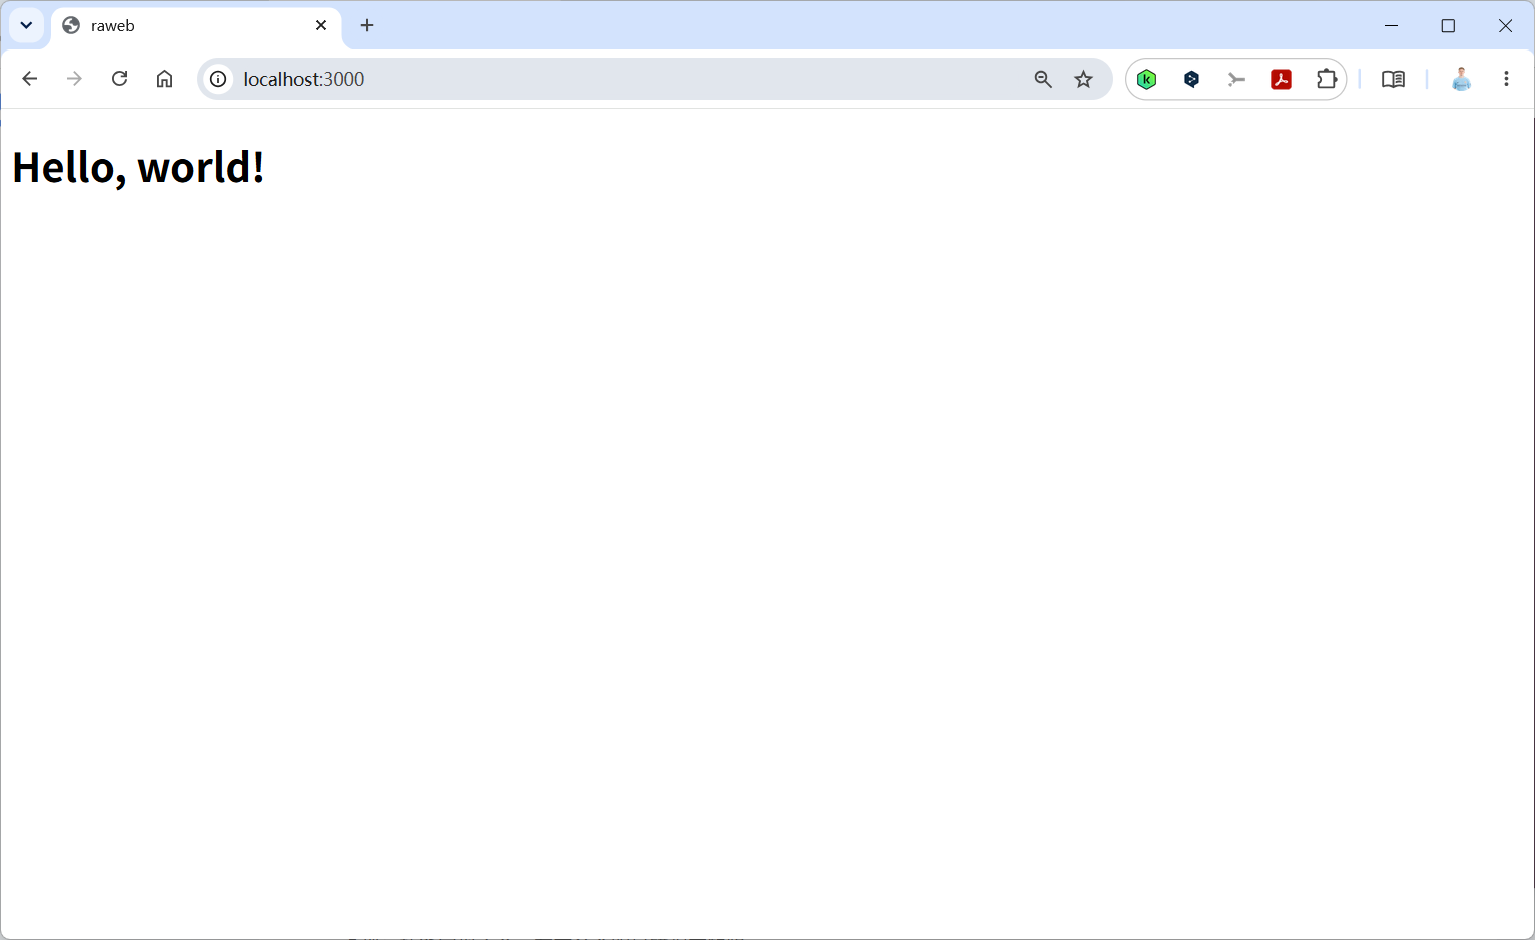
正确响应 GET /(200)
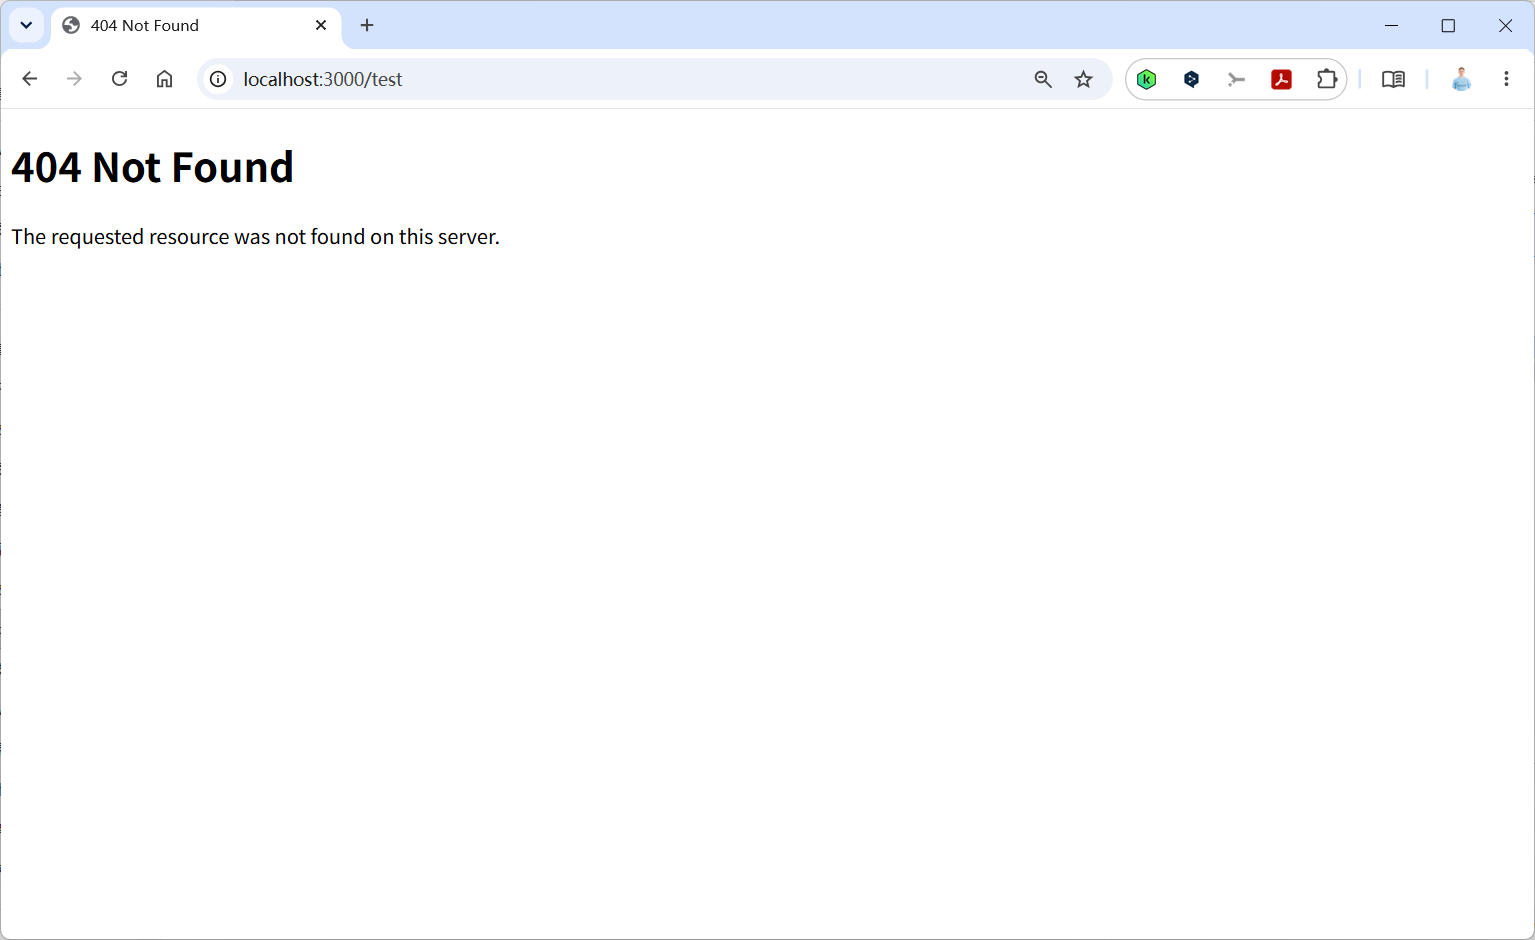
未知路径(404)
非法方法(405)
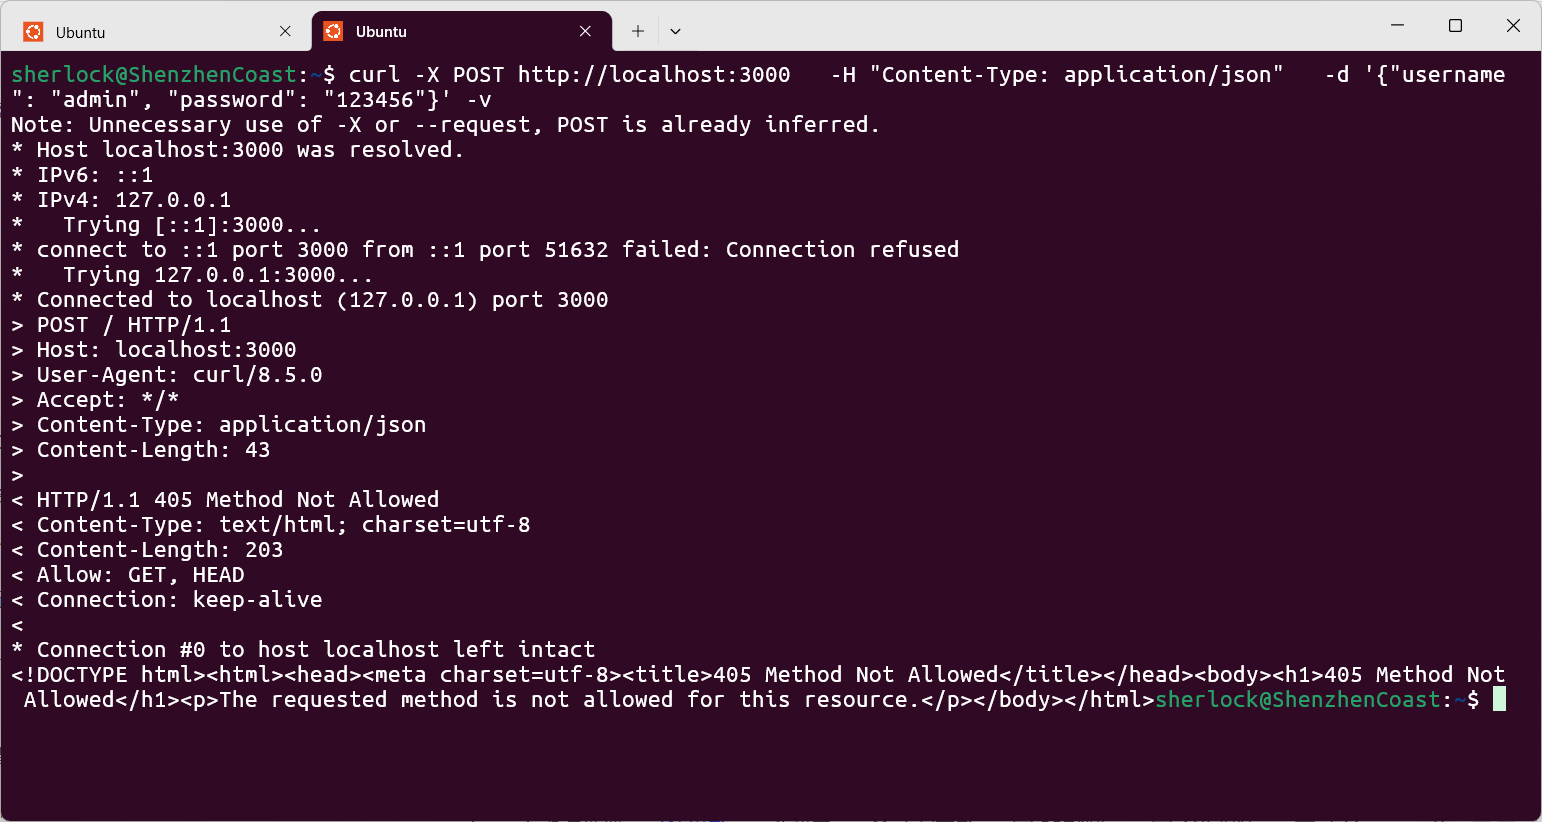
该项目功能简单,但是其精髓在于性能测试部分。
性能测试
测试环境为 Ubuntu 24.04.4 LTS(内核版本 6.18.33.1-microsoft-standard-WSL2) + 13th Gen Intel(R) Core(TM) i7-13620H(16核开满了) + 8GB RAM(WSL设置的,我的电脑不可能才这么点),并没有针对网络高并发场景做内核专门的调优(比如增大连接数之类的)。
raweb
sherlock@ShenzhenCoast:~$ wrk -t 12 -c 10000 -d 60s "http://localhost:3000"
Running 1m test @ http://localhost:3000
  12 threads and 10000 connections
  Thread Stats   Avg      Stdev     Max   +/- Stdev
    Latency     7.25ms    8.55ms 873.73ms   95.72%
    Req/Sec    71.71k    14.70k  145.27k    65.73%
  51347721 requests in 1.00m, 10.52GB read
Requests/sec: 854387.56
Transfer/sec:    179.26MB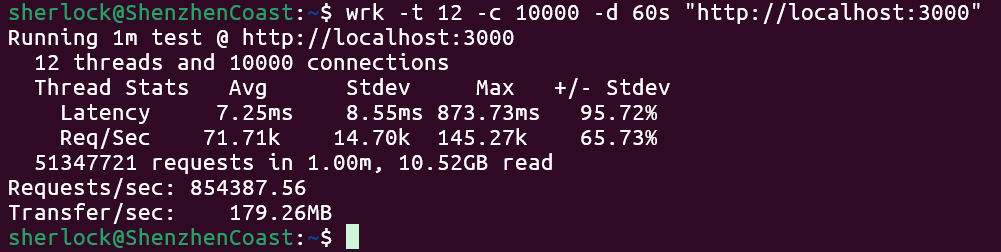
axum
该项目代码十分简单,仅为测试:
use axum::{
    routing::get,
    Router,
};

#[tokio::main]
async fn main() {
    // build our application with a single route
    let app = Router::new().route("/", get(|| async { "Hello, World!" }));

    // run our app with hyper, listening globally on port 3000
    let listener = tokio::net::TcpListener::bind("0.0.0.0:3000").await.unwrap();
    axum::serve(listener, app).await.unwrap();
}
测试结果:
sherlock@ShenzhenCoast:~$ wrk -t 12 -c 10000 -d 60s "http://localhost:3000"
Running 1m test @ http://localhost:3000
  12 threads and 10000 connections
  Thread Stats   Avg      Stdev     Max   +/- Stdev
    Latency    16.59ms   43.85ms   1.41s    99.60%
    Req/Sec    55.98k     8.75k  156.37k    77.66%
  40097750 requests in 1.00m, 4.85GB read
  Socket errors: connect 0, read 0, write 0, timeout 1517
Requests/sec: 667197.86
Transfer/sec:     82.72MB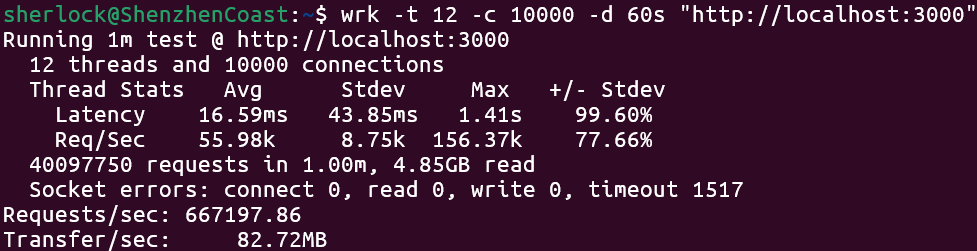
nginx
nginx 由于本身功能繁多,所以结果不尽人意,但我还是关闭了它的日志功能(大幅减少 I/O)以免它说我作弊。
sherlock@ShenzhenCoast:~$ wrk -t 12 -c 10000 -d 60s "http://localhost"
Running 1m test @ http://localhost
  12 threads and 10000 connections
  Thread Stats   Avg      Stdev     Max   +/- Stdev
    Latency    16.96ms   10.34ms 275.46ms   76.98%
    Req/Sec    44.34k     7.72k   87.87k    70.47%
  31695009 requests in 1.00m, 25.44GB read
  Socket errors: connect 0, read 3776, write 0, timeout 0
Requests/sec: 527350.24
Transfer/sec:    433.52MB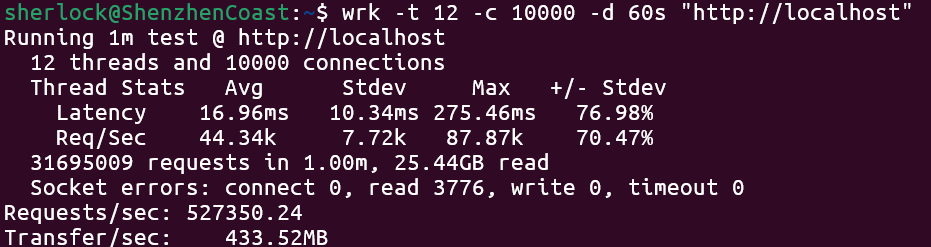
对比分析
(表格由AI帮忙整理)
| 指标 | raweb | axum | nginx |
|---|---|---|---|
| Requests/sec | 854,387 | 667,197 | 527,350 |
| Avg Latency | 7.25ms | 16.59ms | 16.96ms |
| Latency Stdev | 8.55ms | 43.85ms | 10.34ms |
| Max Latency | 873.73ms | 1.41s | 275.46ms |
| Transfer/sec | 179.26MB | 82.72MB | 433.52MB |
| Total Requests | 51.3M | 40.1M | 31.7M |
| Socket Errors | 0 | 1,517 timeout | 3,776 read |
| Stdev 分布 | 95.72% | 99.60% | 76.98% |
不难发现,几乎同样条件下 raweb 可以吊打 axum,在原始吞吐量和延迟方面表现碾压级优势,且零错误,其非常适合需要极致性能的场景。
所以我大致推断,这次对 rust 编写的 server 的性能上限的探索取得了初步成果。
总结
明明是50行代码就可以实现的功能,最后用了将近250行,这就是为了性能优化所必须做出的牺牲,更别提代码可维护性以及可读性了。但是 rust 已经比 C/C++ 好了太多,所以本项目也提供了 nginx 复刻的一种新思路,rust 的编码规范性远远好于 C/C++。